ИИ сдает экзамен на раввина: кто лучше и чего не хватает победителям?
По мере того как ИИ становится привычным инструментом, всё больше людей задают ChatGPT и другим чат-ботам вопросы об алахе, в том числе о самых повседневных вещах. Проект HalachaBench решил проверить, как модели справляются с такими вопросами, если задать их всерьёз и на иврите.
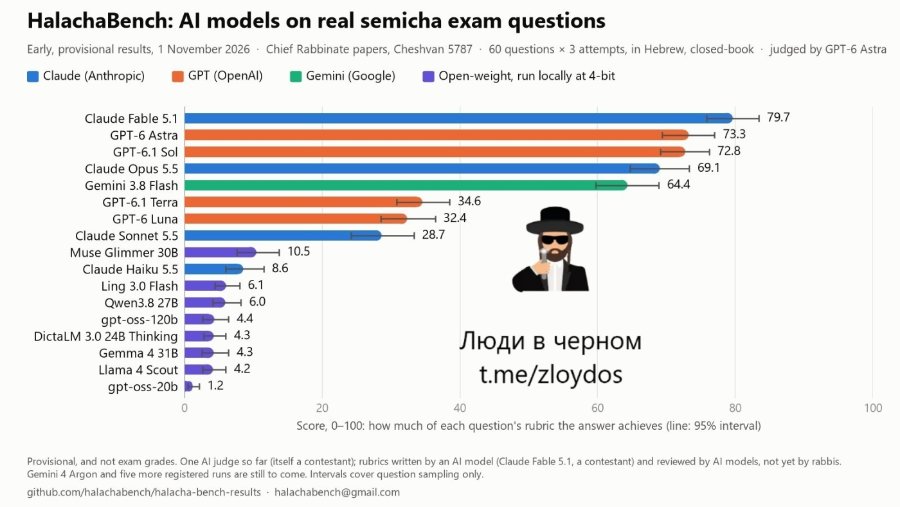
Моделям дали 60 вопросов из пяти работ, которые Главный раввинат Израиля использует при экзамене на раввина. Темы: законы семейной чистоты, бракосочетания, заповеди, связанные с Землёй Израиля, миквы, молитвы и благословения. Книгами и интернетом пользоваться было нельзя, каждый вопрос задавали по три раза. В тестировании участвовали 17 моделей. Ответы проверялись по подробным критериям: какие источники привести, какие мнения упомянуть и как сформулировать итоговое решение.
Лучший результат показал Claude Fable 5.1 (79,7 балла из 100), за ним GPT-6 Astra (73,3), GPT-6.1 Sol (72,8), Claude Opus 5.5 (69,1) и Gemini 3.8 Flash (64,4). Дальше провал: младшие модели тех же семейств набрали от 8,6 до 34,6, а открытые (бесплатные) модели, которые запускали локально, не дотянули до 11 баллов. Даже лидер не дал примерно пятой части того, что ожидалось в полном ответе.
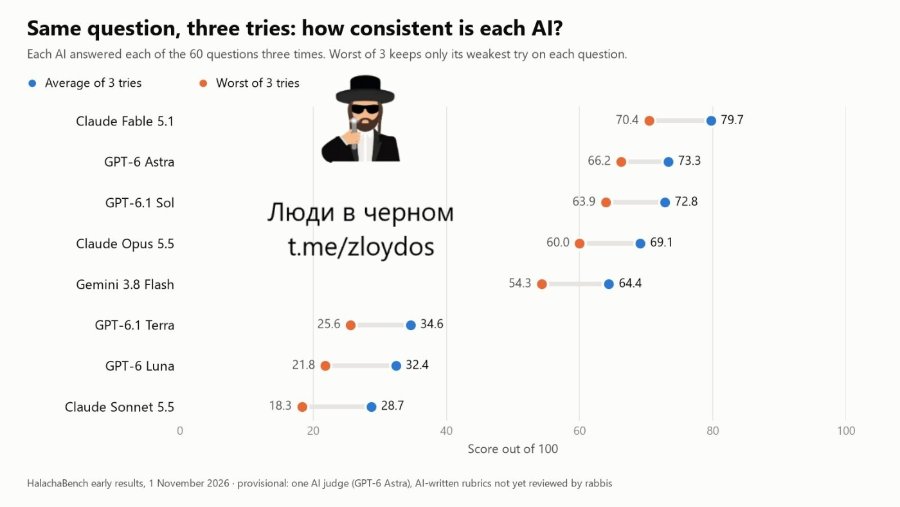
Вторая проблема — нестабильность. Один и тот же вопрос мог получить разные по качеству ответы. Если считать только худшую из трёх попыток, оценки пяти лучших моделей падали на 7–10 баллов: у Claude Fable 5.1 с 79,7 до 70,4, у Gemini 3.8 Flash с 64,4 до 54,3.
Авторы сами подчёркивают, что результаты предварительные и не являются экзаменационными оценками: 80 баллов не означают, что модель сдала бы экзамен. Причины понятны из методики. Все ответы оценивал один ИИ-судья, GPT-6 Astra, который сам участвует в рейтинге. Критерии составил Claude Fable 5.1, занявший первое место, а проверяли их тоже модели. Ни один раввин пока не просмотрел ни критерии, ни ответы. К тому же вопросы раввината часто повторяются из прошлых лет, и модели могли видеть похожие в обучении. Слепую проверку ответов раввинами авторы обещают на следующем этапе.
Главный (промежуточный) вывод эксперимента: ИИ может пригодиться, чтобы найти информацию или разобраться в вопросе, но он не заменяет знания Торы, алахического суждения и руководства квалифицированного раввина. Ответы моделей бывают неполными, противоречивыми и неверными, а по любому практическому вопросу алахи нужно обращаться к живому раввину.